Martedì con due anime. Online, Kling 4.0 è uscito dalla fase di prova ed è aperto a tutti, con clip fino a 30 secondi e tanti riferimenti visivi. In locale, MOSS-Image continua a crescere: arriva un controllo con mappe di colore e profondità, già in fase di integrazione in ComfyUI, e KohakuMoss promette di addestrare LoRA per questo modello anche su schede da 8 GB.
In breve
- Kling 4.0: disponibile per tutti dal 15 ottobre, video fino a 30 secondi e fino a 10 immagini, 5 video e 7 soggetti di riferimento.
- MOSS-Image Color-Depth Control: decidi posizione e forma degli oggetti con una mappa a colori e una di profondità; il nodo è già sul ramo master di ComfyUI.
- KohakuMoss: addestramento di LoRA e LyCORIS per MOSS-Image da 8 GB di VRAM, con esportazione pronta per ComfyUI.
- Nodi partner in ComfyUI: FLUX 3 Video fino a 4K, upscaler video Crystal e voci clonate con HeyGen Voice 1.0.
Kling 4.0 è aperto a tutti
Ne parlavamo da fine settembre, quando Kling aveva annunciato la nuova versione "per ottobre" e aperto solo la variante Flash agli abbonati annuali del piano più alto. Ora ci siamo: Kuaishou ha comunicato il lancio ufficiale di Kling 4.0, avvenuto nella notte del 15 ottobre (ora di Pechino). Secondo il resoconto di 36Kr, il modello genera video fino a 30 secondi, accetta insieme fino a 10 immagini, 5 video e 7 soggetti come riferimento, gestisce piani lunghi e racconti continui e si collega a strumenti esterni tramite MCP e riga di comando.
Perché ti interessa: 30 secondi in un'unica generazione significano meno montaggi di spezzoni da 5–10 secondi e meno salti di coerenza tra un taglio e l'altro. I riferimenti multipli sono la vera arma per chi lavora su un progetto con personaggi, prodotti o ambienti da mantenere uguali. Due cautele, però. Le fonti non concordano sull'uscita in HDR a 10 bit e sull'API per gli sviluppatori: alcune le danno già attive, altre "in arrivo", quindi verifica sul sito prima di contarci per un lavoro. E resta un servizio online a crediti: niente locale, niente ComfyUI se non tramite eventuali nodi partner futuri. Il nostro giudizio: da provare se fai video per clienti e ti servono clip lunghe e coerenti, ma per sperimentare con continuità il costo dei crediti si fa sentire.
Se vuoi farti un'idea prima di spendere crediti, il test di Kingy AI sulle clip da 30 secondi mostra bene pregi e limiti, mentre STOP Wasting Credits & Master Kling 4.0 in 15 Minutes di Youri van Hofwegen è pensato proprio per non sprecarli.
MOSS-Image: composizione guidata con colore e profondità
Chi ha provato i prompt per regioni di MOSS-Image lo sa: gli oggetti finiscono più o meno dove li vuoi, ma posizione e dimensioni tendono a "scivolare". L'img2img tiene la composizione, però si porta dietro anche lo sfondo piatto e i colori del bozzetto. MOSS-Image Color-Depth Control, un adattatore non ufficiale pubblicato da darask0 (lo stesso autore dell'adattatore a 4 passi di cui vi abbiamo parlato nell'aggiornamento precedente), risolve il problema in modo diverso: usa due mappe come condizioni, non come immagine di partenza.
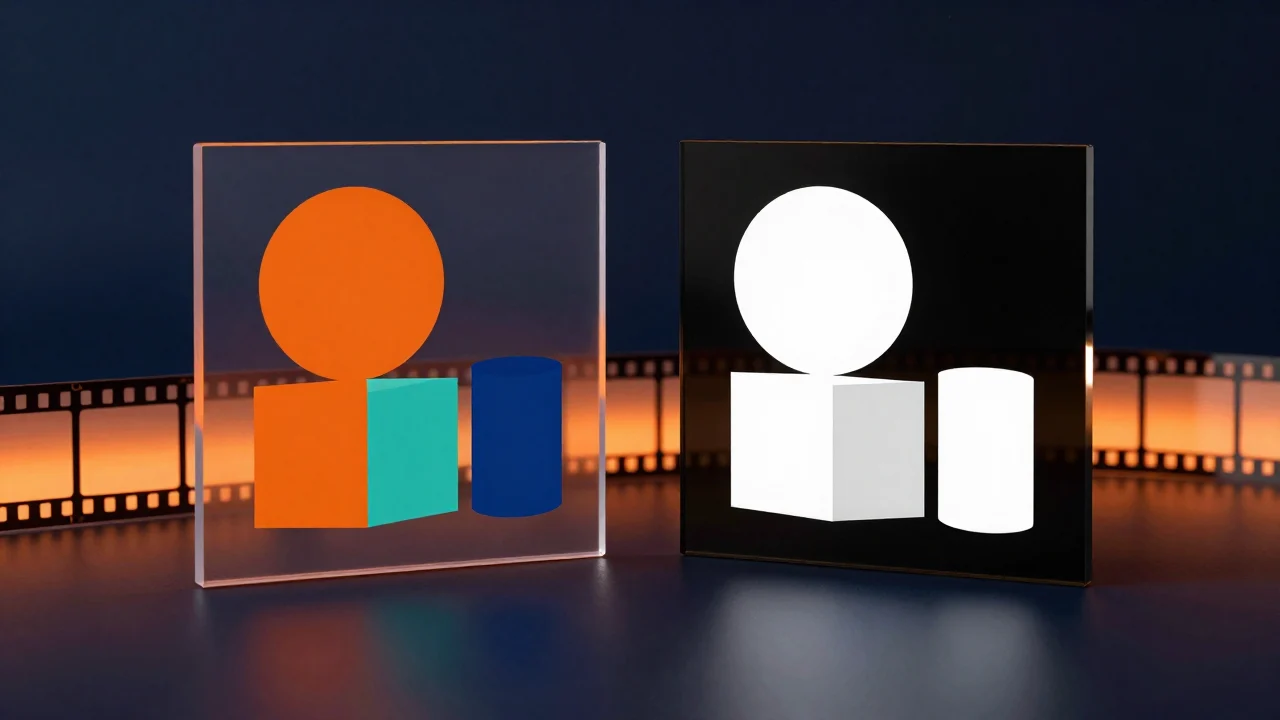
- Mappa colori: ogni oggetto è una macchia di colore piatto e diverso; i colori servono solo a distinguere le regioni, il nero vuol dire "lascia libero".
- Mappa di profondità: in scala di grigi, con gli oggetti vicini in bianco.
- Si possono usare insieme o separatamente, abbinando a ogni colore un prompt di regione.
Per chi viene dal 3D è un'idea molto comoda: si può impostare la scena in Blender o Cinema 4D con manichini e primitive, esportare un render a colori piatti e un passaggio di profondità, e lasciare a MOSS-Image le superfici e lo sfondo, che arrivano dal prompt. L'autore consiglia di fermare il controllo a metà generazione (0.5) per i manichini 3D, così il modello non ne copia la superficie liscia, e di tenerlo fino alla fine (1.0) per mappe ricavate da foto. Abbinato alla versione SFT e all'adattatore a 4 passi dichiara circa 1,8 secondi a immagine da 1024 pixel, ma su una scheda professionale RTX PRO 6000: su una RTX 3060 i tempi saranno ben diversi. La licenza dell'adattatore è Apache-2.0, quindi utilizzabile anche per lavoro. I limiti dichiarati: mani e volti meno precisi della mappa e uno stile che tende al fotografico, perché è stato addestrato su immagini di Krea 2 Turbo.
Sul fronte ComfyUI, kijai ha già scritto il supporto: la modifica #17206, unita il 19 ottobre, aggiunge un nodo sperimentale che codifica le due mappe e le applica in una finestra di passi a scelta. Per ora è solo sul ramo master: arriverà nella prossima versione stabile, dopo la 0.42.1 del 19 ottobre.
KohakuMoss: LoRA per MOSS-Image con 8 GB
KohakuBlueleaf, l'autore di LyCORIS, ha pubblicato KohakuMoss, un programma per addestrare MOSS-Image (Base e SFT). Supporta tutti i metodi di LyCORIS, da LoRA a LoKr, DoRA e OFT, e anche l'addestramento completo del modello. Il punto che ci interessa di più: secondo il README l'addestramento degli adattatori sta in 8 GB di VRAM, e perfino in 6 GB preparando prima le cache. Funziona su Windows (servono i Visual Studio Build Tools), copre anche le RTX serie 30 e salva i LoRA nel formato di ComfyUI, da mettere in models/loras e caricare con il normale LoraLoader, senza nodi aggiuntivi.
Una nota onesta per chi ha un PC come il nostro: la memoria che manca alla scheda video va presa dalla RAM di sistema. Il profilo da 8 GB, secondo i numeri dell'autore, usa circa 19 GB di RAM durante l'addestramento e circa 32 GB nella fase di preparazione: con 32 GB totali si è al limite, quindi chiudi tutto il resto. La licenza è Apache 2.0 con una sola aggiunta: i software derivati devono avere "Kohaku" nel nome. I LoRA e le immagini che crei non hanno vincoli. Insieme agli strumenti di ostris visti nell'aggiornamento precedente, MOSS-Image ha ormai tutto quello che serve per diventare un modello "di comunità", come lo è stato SDXL.
ComfyUI: FLUX 3 Video in 4K, Crystal e HeyGen Voice
Sul ramo master di ComfyUI sono entrati il 19 ottobre tre aggiornamenti dei nodi partner, cioè dei servizi a pagamento usati tramite API. I nodi di FLUX 3 Video ora arrivano a 1440p e 2160p, oltre a 720p e 1080p. Debutta il Crystal Video Upscaler di ClarityAI, che dopo le immagini ingrandisce anche i video. E con HeyGen Voice 1.0 puoi clonare una voce da un massimo di 180 secondi di audio e usarla per la sintesi vocale. Prezzi e lingue supportate non sono indicati nelle modifiche: controllali prima di avviare un lavoro. E ricorda di clonare solo voci di cui hai il permesso.
Da provare subito
Prepara le mappe per il controllo di MOSS-Image direttamente in Blender, anche se non vuoi ancora passare alla versione nightly di ComfyUI. Crea una scena con tre primitive, assegna a ognuna un materiale Emission di colore pieno e diverso, con sfondo nero, e renderizza a 1024×1024: è la tua mappa colori. Poi attiva il passaggio Mist (o Z) nei View Layer Properties, normalizzalo nel Compositor e invertilo, così gli oggetti vicini risultano bianchi: è la mappa di profondità. Quando il nodo arriverà nella versione stabile avrai già il materiale pronto, e intanto le stesse mappe ti servono anche con i ControlNet di profondità degli altri modelli.
Per approfondire
Se sei agli inizi, parti dalla guida introduttiva a ComfyUI. Per confrontare MOSS-Image con FLUX 3 Klein, Qwen-Image e Z-Image c'è la guida ai modelli AI per immagini, mentre per capire dove si colloca Kling 4.0 rispetto ai modelli locali leggi quella sui modelli AI video e il confronto su quanto costa creare con l'AI in locale o online. Se stai pensando di addestrare i tuoi LoRA, la guida alle migliori GPU per l'AI ti aiuta a capire quanta VRAM serve davvero.
È tutto per questa volta. Scarica i nostri workflow gratuiti dalla sezione ComfyUI e seguici sul canale YouTube @tutorial3d. Alla prossima con le novità dell'AI.